 eCommerce
 Sistemi di abbonamento
 RAG Chatbot
 Corsi online
 Prenotazione online
 Guida turistica
 Eventi
 Creatori di contenuti
 Consegna locale e Ritiro in negozio
 Giornale
 Radio
 Scuole e università
 Fede
 Organizzazioni
 Ristorante
 Alimentari
 Costruisci l'app su misura
 Comunicazione con i dipendenti


 APP BUILDER SENZA CODICE
 TECNOLOGIA
 PERCHÉ GOODBARBER?
 Design
 RISORSE DEL PRODOTTO
 TEMI

 RIVENDITORI DI APP
 SCOPRI
Gli agenti IA leggono il Markdown? Cosa dicono due settimane di log del nostro server
Scritto da Dumè Siacci il
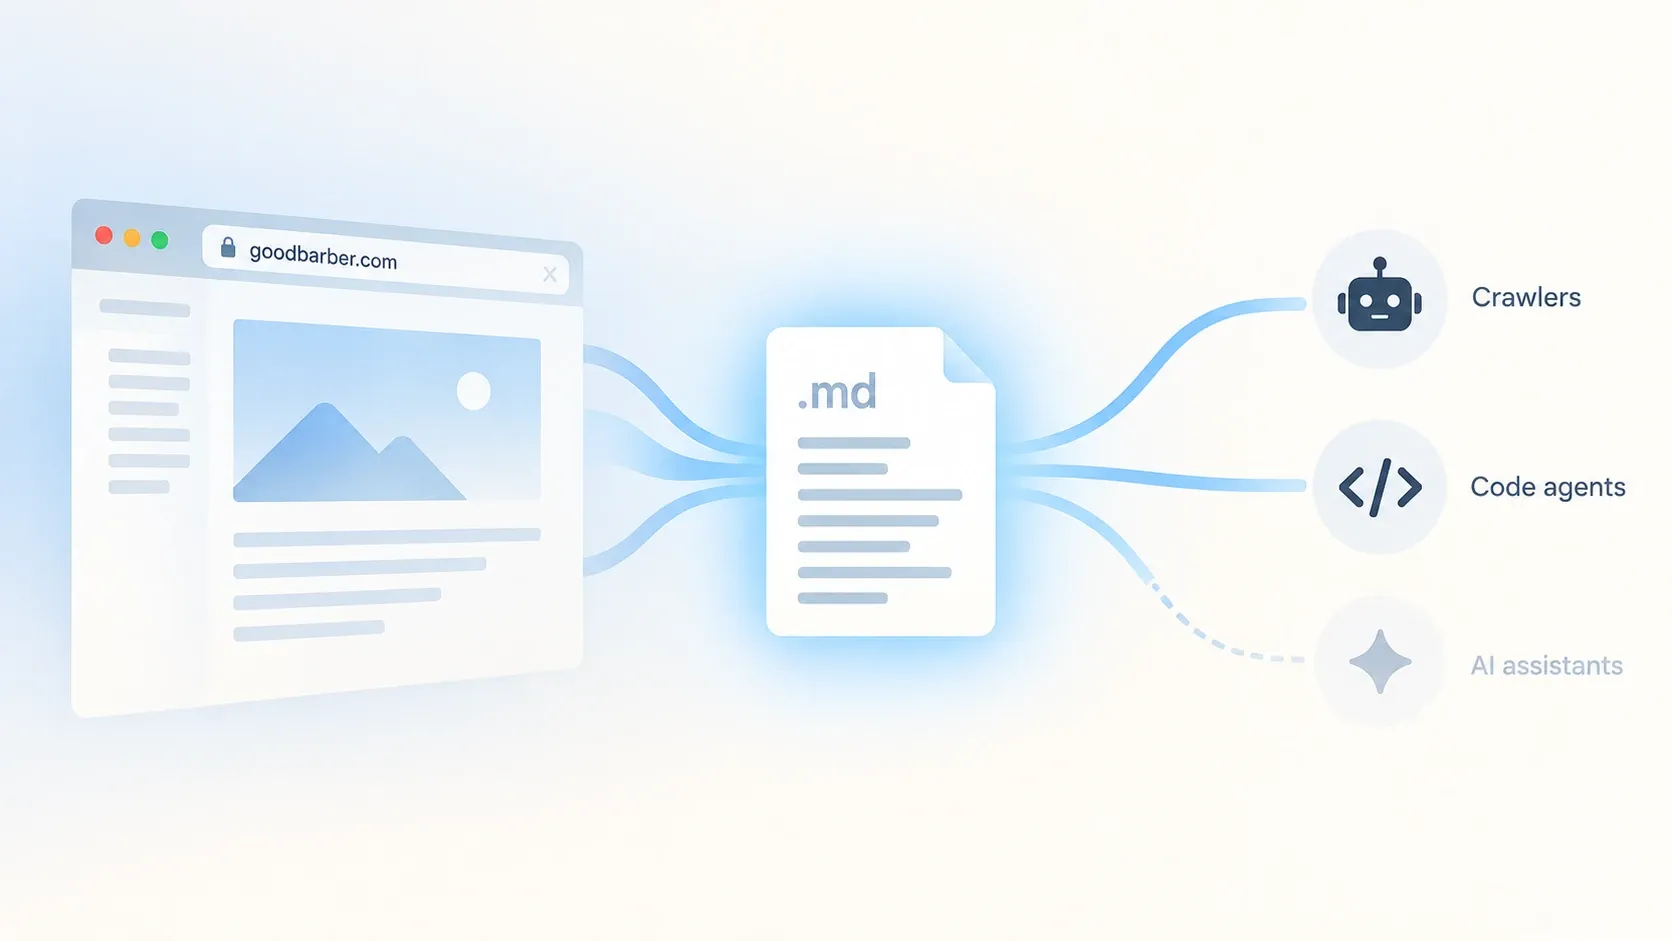
A inizio settembre 2026 abbiamo preso il nostro portale commerciale, quello che state consultando in questo momento, e abbiamo dato a ogni sua pagina un gemello Markdown: basta chiederlo per ricevere la pagina come testo pulito al posto dell'HTML. Poi abbiamo letto i log. I crawler l'hanno preso, gli agenti di programmazione l'hanno chiesto per nome, e gli assistenti che rispondono alle domande delle persone l'hanno ignorato del tutto. Ecco cosa abbiamo misurato, con tanto di date, e cosa potete ricavarne per i vostri contenuti.
Under the hood — l'ingegneria dietro GoodBarber, spiegata a chi gestisce un'app.
Per inquadrare il discorso: tutto quello che segue è successo sul nostro portale commerciale, ed è stato il nostro team a metterlo in piedi. Quello che abbiamo imparato sulle macchine che leggono le pagine web vale per qualsiasi contenuto, il nostro come il vostro.
Da ricordare, dati misurati sul nostro portale dal 4 al 18 settembre 2026:
- I crawler di addestramento e di indicizzazione delle aziende di IA (Amazon, Meta, OpenAI) hanno letto le pagine Markdown tramite il link
.md: circa 80.000 richieste in due settimane. - Gli agenti di programmazione, Claude Code in testa, chiedono il Markdown con l'header
Accept: text/markdowne lo ricevono: circa 22.000 richieste negoziate, quasi tutte da motori di risposta pensati per gli agenti e da Claude Code. - ChatGPT, Claude sul web e Perplexity, quando rispondono a una persona, hanno recuperato l'HTML più di 13.000 volte e il Markdown una volta sola.
- Il crawler di Google non ha chiesto nemmeno una pagina Markdown.
- Il Markdown pesa circa l'80% in meno della pagina HTML da cui deriva.
Perché servire Markdown agli agenti IA
GoodBarber è una piattaforma no-code per creare app mobile; goodbarber.com è il suo sito commerciale, in undici lingue, con pagine di marketing, un blog e un centro assistenza. Quando qualcuno chiede a un assistente IA se con GoodBarber si può realizzare l'app che ha in mente, l'assistente non legge la nostra brochure. Recupera le nostre pagine, a volte a migliaia in un giorno, e spreme una risposta fuori dall'HTML. L'HTML è pesante: menu, script, impaginazione, banner dei cookie. Il Markdown è il testo della pagina e nient'altro. Servirlo quando lo chiede una macchina significa che l'assistente legge il contenuto vero, più in fretta, a una frazione del peso, con meno probabilità di sbagliare su di noi.
Ad agosto 2026 Pierre-Laurent aveva contato chi legge il nostro llms.txt. Un llms.txt è un file di testo posto alla radice di un sito, che ne elenca le pagine importanti a beneficio dei sistemi di IA: in quattro mesi, nessun assistente era venuto a cercarlo di propria iniziativa. Gli stessi log mostravano un'altra cosa: nello stesso periodo, gli assistenti e i loro crawler avevano recuperato le nostre pagine normali 1,6 milioni di volte. Nessuno legge la mappa; tutti girano per le strade. La domanda quindi non era «come convincerli a leggere l'indice», ma «cosa mettergli in mano quando arrivano».
Come il nostro portale serve il Markdown: negoziazione del contenuto e URL .md
Due porte, nessun contenuto duplicato. La prima è la negoziazione del contenuto, il meccanismo standard del web con cui un client dichiara nella sua richiesta il formato che preferisce: un client che invia l'header Accept: text/markdown riceve la versione Markdown di qualsiasi pagina pubblica, allo stesso indirizzo. La seconda è un indirizzo gemello: un client che aggiunge .md all'indirizzo di una pagina, /pricing.md, /blog/<article>.md, riceve la stessa cosa. Anche questa pagina ha il suo gemello: aggiungete .md al suo indirizzo. Ogni pagina HTML annuncia il suo gemello con un link standard, così come annuncia le sue traduzioni. Il Markdown viene generato dall'HTML esatto che la pagina già serve, quindi non può mai dire qualcosa che la pagina non dice, e chiede ai motori di ricerca di non indicizzarlo: la pagina HTML resta l'unica presente in Google.
Prima di attivarlo, il test consisteva nel verificare che un visitatore umano non potesse accorgersi di nulla: risposte confrontate byte per byte con il gemello attivo e disattivato, su tutti i tipi di browser che ci sono venuti in mente, identiche, al costo di pochi microsecondi per richiesta.
Non abbiamo inventato niente di tutto questo. Cloudflare converte le pagine in Markdown sull'edge della sua rete da febbraio 2026, Zapier e Vercel servono entrambe le porte sui propri siti. Se gestite un sito web e volete la stessa cosa, si tratta di una giornata di lavoro lato server, una libreria di conversione, una cache e un modo per verificare che per gli umani non sia cambiato nulla. Quello che quasi nessuno fa è il passo successivo: contare.
I crawler IA leggono il Markdown?
Dal 4 al 18 settembre 2026, due log dedicati hanno registrato ogni richiesta di una pagina Markdown, sulle undici versioni linguistiche del nostro sito, escluso il nostro traffico. Ogni «chi» qui sotto è un nome dichiarato, confrontato con gli indirizzi IP che il suo operatore pubblica, come aveva fatto Pierre-Laurent; dove un operatore non pubblica nulla, il nome resta soltanto dichiarato.
Sì, e sono loro a prendere il link .md: circa 80.000 richieste in due settimane. La metà arriva dai crawler delle aziende di IA, quelli che costruiscono i dataset di addestramento e gli indici di ricerca: Amazon, Meta, OpenAI, tutti dai rispettivi indirizzi IP pubblicati. I crawler di OpenAI trovano la versione .md perché la nostra pagina HTML la segnala: in 99 casi su 100, lo stesso crawler aveva recuperato la pagina HTML nei dieci minuti precedenti. È passato anche il crawler di Bing, ma ha speso gran parte della visita sulle nostre pagine di ricerca interna, che rispondono a qualunque cosa venga digitata da chiunque. Il crawler di Google, invece, non ha chiesto nemmeno una pagina Markdown.
Gli agenti di programmazione inviano Accept: text/markdown?
Sì, quasi sistematicamente. L'header ha ricevuto circa 22.000 richieste, un quarto di quelle del link, e da un pubblico diverso. Quasi tutto arriva da due motori di ricerca costruiti per gli agenti IA, ShapBot ed ExaSearchBot, e da un solo agente di programmazione: Claude Code, lo strumento che gli sviluppatori, e non solo loro, fanno girare sulla propria macchina. Claude Code ha inviato l'header praticamente in ognuna delle sue circa 1.400 richieste di pagina e ha ricevuto Markdown 98 volte su 100, per tre quarti sul nostro centro assistenza. È coerente con quello che Checkly aveva misurato a febbraio 2026: Claude Code, Cursor e OpenCode inviano l'header; Codex, Gemini CLI, Copilot e Windsurf no.
ChatGPT, Claude e Perplexity recuperano il Markdown?
No, nessuna delle due porte. È il numero su cui avremmo perso la scommessa. In due settimane, le richieste partite perché qualcuno aveva fatto una domanda a ChatGPT hanno recuperato più di 10.000 delle nostre pagine HTML e una sola pagina Markdown, tre minuti dopo l'attivazione, molto probabilmente uno di noi che stava facendo una prova. Claude sul web: circa 2.700 pagine HTML, zero Markdown. Perplexity: circa 900, zero. Recuperano la pagina HTML e la ripuliscono per conto loro. Niente di quello che serviamo cambia le cose.
Chi legge cosa, e a quale scopo:
| Agente (dichiarato) | Cosa fa con la pagina | HTML | Link .md | Header Accept |
|---|---|---|---|---|
| Amazonbot, Meta-ExternalAgent | raccoglie dati per l'addestramento | sì | sì, di sua iniziativa | no |
| ClaudeBot | raccoglie dati per l'addestramento | sì | sì, circa quattro .md ogni dieci pagine HTML | no |
| GPTBot | raccoglie dati per l'addestramento | sì | sì, seguendo il link della nostra pagina | no |
| OAI-SearchBot | costruisce l'indice di ricerca di ChatGPT | sì | sì, seguendo il link della nostra pagina | no |
| PerplexityBot | costruisce l'indice di Perplexity | sì | no | no |
| Bingbot, Applebot, Baidu | indice di ricerca classico | sì | sì (Bing soprattutto sulle pagine di ricerca) | no |
| Googlebot | indice di ricerca classico | sì | no | no |
| ShapBot, ExaSearchBot | indice per le risposte degli agenti IA | sì | no | sì, su quasi ogni richiesta |
| Claude Code | agente di programmazione, recupera su richiesta | sì | no | sì, praticamente su ogni richiesta |
| ChatGPT-User, Claude-User, Perplexity-User | recupera una pagina per rispondere alla domanda di una persona | sì | no (una richiesta in due settimane) | no |
Due fatti minori. Il Markdown pesa circa l'80% in meno della pagina HTML da cui deriva, quasi l'85% sul centro assistenza. E prima ancora che servissimo qualsiasi Markdown, i nostri log contenevano già circa 900 richieste verso indirizzi .md che non esistevano, README.md, agents.md, CLAUDE.md, lanciate da strumenti che si aspettano che un sito web sia un repository di codice; uno di loro aveva indovinato gli indirizzi esatti che abbiamo pubblicato un mese dopo.
Cosa cambia per i vostri contenuti
Tre cose, tratte dai nostri log e non dalle slide di nessuno.
Il vostro HTML è ciò che leggono gli assistenti. ChatGPT, Claude e Perplexity recuperano la pagina che vede una persona. Una pagina pulita, aggiornata e ben strutturata è ciò che arriva loro; un gemello Markdown no, almeno non oggi. Pierre-Laurent ha scritto come correggere i contenuti che gli assistenti citano quando sbagliano sulla vostra attività; quel lavoro riguarda l'HTML, ed è quello che ripaga.
I crawler seguono i link che pubblicate. I crawler di OpenAI hanno preso il link .md perché la pagina glielo offriva. Se indicate una strada ai crawler, la imboccano. È anche per questo che avere un llms.txt vale ancora la pena: da quando le nostre pagine puntano a quel file, i crawler di OpenAI ci arrivano dal nostro stesso sito, mentre prima lo trovavano attraverso directory di terze parti.
Gli agenti di programmazione chiedono il Markdown per nome. Se gli sviluppatori fanno parte del vostro pubblico, gli agenti che usano inviano Accept: text/markdown e si servono di quello che ricevono. È nel nostro centro assistenza che sono andati.
Se gestite un'app GoodBarber, la sua versione web è già la pagina che un assistente può recuperare e citare, e GoodBarber MCP permette a un assistente di aiutarvi a tenere aggiornati quei contenuti. Le pagine che gli assistenti leggono davvero sono quelle che già pubblicate.
Domande frequenti
Vale anche per le app create con GoodBarber?
Non direttamente: questo articolo parla del nostro portale. Quello che vale già per la vostra app è la lezione: gli assistenti leggono la pagina HTML che vede una persona, quindi ciò che conta è tenere aggiornati quei contenuti.
Il sito di GoodBarber è leggibile dagli agenti IA?
Sì. Da settembre 2026, ogni pagina pubblica di goodbarber.com esiste in Markdown, tramite l'header Accept: text/markdown o aggiungendo .md al suo indirizzo, e ogni pagina HTML annuncia quella versione con un link standard. Il sito pubblica anche un llms.txt e un llms-full.txt, rigenerati ogni notte a partire dalle pagine, e ogni pagina rimanda a entrambi.
Un agente IA può lavorare con un'app GoodBarber?
Sì, tramite GoodBarber MCP: un assistente come Claude o ChatGPT può collegarsi alla vostra app per leggerne e modificarne i contenuti, pubblicare un articolo o programmare una notifica, con la vostra approvazione. È un argomento diverso da quello di questo articolo, ed è descritto nella pagina di GoodBarber MCP.
Gli assistenti IA leggono le versioni Markdown delle pagine web?
Non gli assistenti per il grande pubblico, nei nostri log di settembre 2026. ChatGPT, Claude sul web e Perplexity hanno recuperato le nostre pagine HTML più di 13.000 volte in due settimane, e le nostre pagine Markdown una volta. I crawler e gli agenti di programmazione, invece, il Markdown l'hanno usato.
Servire il Markdown è utile per Google?
No, e non è questo lo scopo. Le nostre pagine Markdown chiedono ai motori di ricerca di non indicizzarle e rimandano alla pagina HTML. Il crawler di Google non ne ha mai richiesta una.
Devo aggiungere un llms.txt al mio sito?
Costa poco, e i crawler lo leggono davvero quando le vostre pagine puntano a quel file. Nei nostri log lo leggono crawler, directory e strumenti SEO, non gli assistenti che rispondono alle domande delle persone.